オールラウンダーか、職人か――AMMI/GGEで読む品種×環境交互作用
平均収量が同じなら、同じように優秀なのか
説明のため、4つの環境で2品種を試験したという架空の例を考える。以下の数値は実測値ではなく、単位を省略した合成例である。
| 環境 | 品種A | 品種B |
|---|---|---|
| E1 | 8 | 12 |
| E2 | 8 | 12 |
| E3 | 8 | 4 |
| E4 | 8 | 4 |
| 平均 | 8 | 8 |
平均収量だけなら、両者は同じである。しかし、その意味はまったく違う。
品種Aは、どこへ持っていっても8程度を取る。いわばオールラウンダーである。一方、品種BはE1・E2ではAを大きく上回るが、E3・E4では大きく下回る。こちらは特定の環境で強い職人型である。
つまり、「どちらの平均値が高いか」だけでは、育種上の問いに答えられない。 必要なのは、どの遺伝子型が、どの環境で、どのように反応するのかを見ることである。
G×Eとは何か
多環境試験(Multi-Environment Trial; MET)で観測される表現型は、単純化すれば、遺伝子型そのものの違いG、環境そのものの違いE、遺伝子型によって環境への反応が異なるG×E、実験誤差やその他の変動から構成される。
どの環境でもA > Bなら、差の大きさが変わっても順位は変わらない。しかしE1ではA > B、E2ではB > Aとなれば、環境によって品種順位が逆転する。このような相互作用をcrossover interactionという。
育種で特に重要なのはこちらである。なぜなら、「最も優れた品種」が環境によって変わるからだ。
AMMIは、G×Eの中身を分解する
G×Eを扱う代表的な古典的方法の一つが、AMMI(Additive Main Effects and Multiplicative Interaction)である。Zobel, Wright, and Gauch(1988)は、加法的な主効果と乗法的な交互作用を組み合わせ、収量試験のG×E構造を少数の軸へ分解した。
まずGとEの主効果を分け、そのうえで、各遺伝子型が各環境で平均的な期待からどれだけ特異的にずれたかというG×E部分を少数の乗法的成分へ分解する。
AMMIの図で何を見るのか
ここではYan et al.(2000)の研究でも使われた、1993年Ontario冬コムギ試験の18品種×9環境データを用いる。
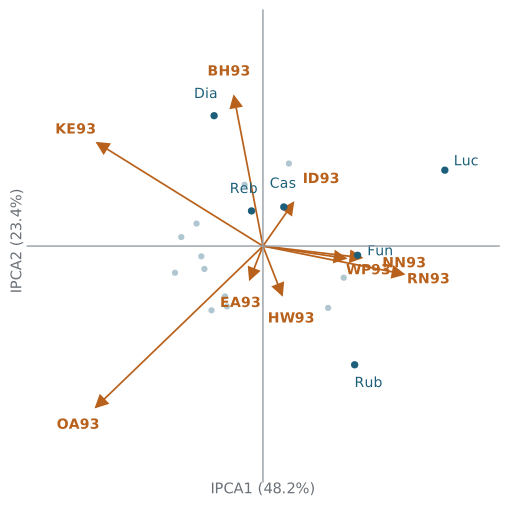
交互作用スコアが原点付近にある遺伝子型は、この低次元表現において比較的小さなG×Eを示す。一方、大きく離れた品種は、特定環境に対して特徴的な反応を示している可能性がある。
ただし、原点に近い = 良い品種ではない。安定していても平均収量が低ければ魅力的とは限らず、高い平均収量を持ちながら特定環境への強い反応を示す品種もありうる。性能の高さと、反応の安定性は別の軸である。
GGEバイプロットは、「どの品種を選ぶか」に焦点を寄せる
GGEでは各環境の平均を中心化し、残ったG + GEを特異値分解によって低次元に表現する。AMMIがGとEの主効果を分けたうえでG×Eをどう理解するかに重点を置くのに対して、GGEは品種の平均的な性能と、環境ごとの品種反応を合わせてどう見るかという選抜側の問いに寄せた表示だと理解すると分かりやすい。
Which-Won-Where――どの品種が、どこで勝ったのか
GGEバイプロットで最も有名な表示の一つがWhich-Won-Whereである。
この考えを育種地域へ広げれば、メガ環境(mega-environment)という発想につながる。つまり、同じような品種順位が再現される環境群を一つの選抜単位として扱えないかと考える。
Which-Won-Whereは「真のメガ環境」を発見する装置ではない
一枚のバイプロット上で同じsectorに入ったことと、生物学的・農業的に安定したメガ環境であることは同じではない。
Yan et al.(2000)は1989〜1998年のOntario冬コムギ試験を解析し、二つのメガ環境として扱える可能性を示した一方、主要地域内のlocation groupingは年によって変化し、さらに安定した下位のメガ環境へ細分化することはできなかった。
だから私はWhich-Won-Whereを、メガ環境の答えというより、メガ環境についての仮説生成器として見る方がよいと思う。
PC1とPC2だけで世界を説明してよいのか
今回のデータでも、AMMI2はG×E平方和の71.7%、GGEのPC1・2はG+GEの78.0%を表現している。どちらもすべての情報を描いているわけではない。
なお、この二つの割合は直接比較できない。AMMIの71.7%はG×E平方和を分母とし、GGEの78.0%はG+GEを分母としているからである。
二次元図はデータそのものではない。高次元の試験結果を、人間が解釈できる形へ圧縮したものである。圧縮すれば、必ず何かを捨てる。
また、PC1とPC2は自動的に「安定性の軸」と「地域適応性の軸」になるわけではない。軸は、対象とした変動を効率よく表すように計算される。二次元に残らなかった成分にも反応があるので、原点に近いことだけで、すべての環境への安定性を保証することはできない。中心化・標準化の方法、軸に残った情報量、採用する成分数を確認したい。AMMI/GGEのモデル選択と予測評価の重要性は、Gauchら(2008)の方法論的検討でも論じられている。
「安定した品種」は、本当に優秀なのか
最初の例へ戻る。広い地域へ一品種だけ普及させなければならないなら、どの環境でも8を取るAは魅力的である。しかしBが12を取る環境だけを見るなら、Bを捨てる理由はない。むしろBこそ選ぶべきかもしれない。
つまり、安定性は、それ自体で絶対的な価値ではない。 どの範囲の環境を一つの育種目標として扱うかによって、望ましい品種は変わる。
なお、最初の例でいう「安定」は、収量自体が変わらないという意味で単純化している。実際の品種評価では、好適な環境では収量が伸び、不利な環境では下がるという全体的な変化に沿いながら、そこからのずれが小さいことも安定性と呼ぶ。収量の変動が小さいことと、G×Eが小さいことは同じではない。 どの定義で安定性を評価するかを、平均収量や減収リスクと一緒に示す必要がある。
現実のMETは、きれいな長方形ではない
実際の育種試験では、ある年だけ供試した系統がある、全地点にすべての系統を配置できない、圃場内に空間的な土壌勾配がある、環境ごとに誤差分散が違う、年によって試験設計が異なる、といったことが普通に起こる。
同じ品種群の観測値を環境間で単純に相関させても、「似ている環境」「異なる環境」という構造はある程度見える。
ここから、試験誤差などを考慮したうえで、環境間の遺伝的な反応がどれだけ似ているのかを推定したくなる。そこで重要になるのが線形混合モデル(linear mixed model)と因子分析型(FA)分散共分散構造である。
FA混合モデル――環境間の「似ている/似ていない」をモデルにする
Smith, Cullis, and Thompson(2001)は、多環境試験の品種×環境効果を因子分析型構造で表現するmultiplicative mixed modelを提案した。重要なのは、各環境の遺伝分散を別々に認めながら、環境間の遺伝共分散を少数の潜在因子で表現するところにある。
AMMI/GGEがG×Eを理解・可視化する優れた入口であるのに対し、FA混合モデルは不均衡なMETを混合モデルとして統合し、選抜や予測へつなげやすい。両者は単純な「古い方法 vs 新しい方法」ではない。問いが少し違う。
ただし、FAモデルが既知の環境間に推定した共分散だけでは、データのない新しい環境をどこに位置づけるかは決まらない。既知環境で欠けた組合せを補うことと、新しい地域や将来年へ予測を広げることは区別したい。後者には、環境特徴量などを通じて新しい環境と既存試験を結ぶ情報が必要になる。
可視化から予測へ
さらに現在の育種では、試験した環境で何が起きたかだけではなく、まだ試験していない遺伝子型×環境で何が起きるかを予測したくなる。
Jarquín et al.(2014)は、コムギ139系統、2,395 SNP、68の環境共変量を用いた反応規範型モデルで、マーカーと環境共変量の交互作用を組み込むことで、主効果のみのモデルより予測相関が改善することを示した。
重要なのは方向性である。G×E解析は、どの環境で誰が勝ったかを見るところから、なぜその環境で反応が変わったのか、その情報を使って未観測の組合せを予測できないかという問題へ広がっている。
「環境」とは、場所の名前ではない
生物が「京都2025」という名前に反応しているわけではない。気温、水分、日射、土壌、病害圧、栽植条件、生育段階ごとのストレス。そうした多数の物理・生物学的条件に反応している。
だからG×Eの先には、Eを単なるカテゴリではなく環境特徴量として記述するという発想がある。
近年の研究は、何を予測しようとしているのか
環境情報を加えるという方向は、近年の実証研究でも検討されている。
Fernandesら(2024)のトウモロコシ研究では、Genomes to Fieldsの試験データを用い、ゲノム情報に気象・土壌などの情報を組み合わせた機械学習モデルを比較している。環境情報の追加は予測に役立った一方、既知環境で欠けた組合せを予測する場合と、別年を予測する場合では成績が異なった。私はここから、「環境情報を加えた」というモデル名だけでなく、何を未知として評価したかまで読む必要があると考える。
また、モデルの複雑さが、そのまま優位性になるわけでもない。Avagyanら(2025)は、品種ごとの環境応答を線形に表し、過剰な当てはめを抑える罰則を加えた回帰を検討した。トウモロコシの実測データとコムギのシミュレーションデータでは、比較対象の深層学習などと同程度の予測精度を、より小さな計算負荷で得ている。この研究の対象は主に、既に試験した品種を新しい環境へ移す場面であり、未試験品種のゲノム予測まで一括して実証したものではない。
さらに、2026年7月に公表されたEckhoffらのライムギ研究は、もう一段踏み込んでいる。この研究は分子マーカーや家系情報を用いず、表現型と環境情報からG×Eを予測したものである。全体の収量をよく当てるモデルでも、環境ごとの平均収量を捉えることに偏り、その環境の中でどの品種が優れるかを十分に捉えられない場合がある。そこで、予測する値の作り方や、学習時に誤差を評価する関数を工夫し、環境内の品種差・順位の予測を改善した。
これらは、それぞれの作物、試験、比較条件で得られた結果である。あらゆる作物で同じ改善が得られるとは言えない。それでも、私には一つの方向が見える。AIに何を入力するかだけでなく、何を当てれば選抜に役立ったと言えるのかを、先に定める。 それは最初の「何を優れた品種と呼ぶのか」という問いに、もう一度戻ることでもある。
「未知」をそろえて、予測を確かめる
もし自分がこれから予測モデルを比較するなら、まず利用場面を次のように分けたい。
- 既知の品種・既知の環境で、未観測の組合せを補う。 品種と環境の情報は学習側に残し、組合せの一部を評価用に隠す。
- 新しい品種を、試験済みの環境で評価する。 評価対象の品種の表現型を、学習側の全環境から外す。
- 既知の品種を、新しい地域や将来年へ展開する。 地域単位、または年単位で評価データを分ける。
- 新しい品種を、新しい環境で評価する。 品種と環境の両方を学習側から外し、どこまで予測できるかを別に調べる。
これは今後の検証方針であって、私がこの四つを実施して結果を得たという報告ではない。これらの区別は、Avagyanら(2025)が整理する予測場面とも対応する。どの場面を再現するかによって、適切なデータの分け方は変わる。
将来年を予測したいのに、同じ年の観測を無作為に学習用と評価用へ分けただけでは、その用途を十分に確かめたことにならない。前処理や変数選択、モデルの調整も、評価用の答えを見ずに行う必要がある。
そして、全環境をまとめた予測相関だけで満足しない。環境内の品種順位、選んだ上位品種が実際にも上位に入る割合、収量の誤差を併せて見る。減収を避けたいなら、厳しい環境での外し方も見る。良い予測指標とは、そのまま良い意思決定なのか。 この問いを、モデルの評価から外さないようにしたい。
それぞれの方法は、違う問いに答える
| 方法 | 主に扱うもの | 主な問い |
|---|---|---|
| AMMI | G×E | 交互作用にはどんな低次元構造があるか |
| GGE | G + GE | どの品種が、どの環境で優位だったか |
| FA混合モデル | 環境間の遺伝共分散 | 不均衡METからどう選抜・予測するか |
| 反応規範 | G+環境特徴量+交互作用 | 未観測のG×Eを予測できるか |
AMMI/GGEが「古いから不要」という話ではない。AMMI/GGEは終着点ではなく、G×Eを考え始めるための優れた入口である。
「オールラウンダーか、職人か」という問いは消えない
統計モデルがどれだけ高度になっても、最初の問いは残る。広い環境で安定して高い性能を示す品種を選ぶのか。特定環境で突出した品種を選ぶのか。将来の気候変動まで考えて安定性を重視するのか。環境を細分化し、それぞれに専用品種を配置するのか。
統計は何が起きているかを推定できる。さらに、この環境ならこの品種がどの程度の性能を示しそうかを予測することもできる。しかし、どの未来を望ましいとするかまでは決めてくれない。
これは「AIと哲学03」で考えた最適化の問題とも似ている。どれほど精密な最適化でも、何を目的関数へ入れるかは別問題である。
統計解析は、価値判断を消すための道具ではない。むしろ、自分たちがどの価値を選抜へ入れているのかを明示するための道具なのだと思う。
反論・限界
AMMI/GGEにも、FA混合モデルにも、反応規範型モデルにも万能性はない。AMMI/GGEの結果は試験した遺伝子型と環境に依存し、Which-Won-Whereの環境群が将来年にも再現する保証はない。低次元バイプロットではG×Eの一部を捨てる。
FAのfactor loadingも自動的に高温や乾燥という生物学的意味を持つわけではない。環境共変量を使うモデルでも、どの変数をどの生育段階・時間解像度で記録するかによって性能は変わる。
環境情報を加えて予測が改善しても、その変数が生理学的な原因だと証明されたわけではない。例えば気温と日射、降水と土壌水分は一緒に動くことがある。IPCAスコアとの相関や機械学習の変数重要度は、確かめるべき仮説を示す手がかりとして扱い、因果的な説明には別の実験や検証が必要だと考える。
そして、どの方法でも悪い試験設計や不十分な環境サンプリングを完全に救うことはできない。
高度なモデルは、情報のないところから情報を作り出す魔法ではない。
今後の展望――どの未来に対して安定しているのか
私が今後試してみたいのは、公開データを入口に、気象の年平均だけでなく、開花期や登熟期といった生育段階ごとの環境情報を整理し、ゲノム情報と結びつけて予測を比較することである。その際も、基本的な統計モデルを比較の基準に残し、複雑なモデルを使う価値がどこにあるかを確かめたい。
ここには、まだ難しい問題がある。播種前には、その年の生育期間全体の気象は分からない。収穫後に実測気象を入力して当てた結果は、播種前に品種を選ぶ予測と同じではない。過去の気象を使って複数の年を想定する方法は、Eckhoffら(2026)の研究でも検討されている。ただし、過去の範囲を超える高温や乾燥への適応まで、確立したことにはならない。
将来展望としては、一つの予想収量を提示するだけでなく、複数の気象条件での性能と、その不確かさを示す形を考えたい。その結果を見て、どの条件の試験を追加すれば品種選択の迷いが減るかを判断する。予測を次の観測へつなぎ、観測によって予測の適用範囲を確かめる、という循環である。
そのとき「安定した品種」という言葉には、問いを添える必要がある。どの地域、どの栽培管理、どの未来の気象に対して安定しているのか。 AIがその条件を自動的に決めてくれるわけではない。だからこそ、何を予測するかを明示することが、将来の育種への第一歩になると思う。
結論:G×Eは、平均値の外側にある育種情報である
平均収量が同じ二つの品種。一つはどこでも8を取る。もう一つはある環境では12、別の環境では4になる。これを「平均8だから同じ」と扱った瞬間に、育種上重要な情報を捨てている。
G×Eが教えてくれるのは、品種の能力は、環境から完全に切り離して語れないということである。
AMMIはG×Eの構造を分解し、GGEはどの品種がどこで優位だったのかを見せる。FA混合モデルは環境間の遺伝共分散をモデル化し、不均衡なMETから選抜・予測へつなげる。そしてゲノム情報と環境情報を組み合わせるモデルは、観測したG×Eを理解するところから、まだ観測していないG×Eを予測するところへ向かっている。
それでも最後に残る問いは、統計学以前のものかもしれない。
オールラウンダーと職人の、どちらが優れているのか。
私の答えは、それだけでは決められない。
どこで栽培するのか。どれだけ広く普及させるのか。どの程度のリスクを許容するのか。何を育種目標にするのか。その問いに答えて初めて、「優れた品種」の意味が決まる。
統計学は、その価値判断を代わりにしてくれるものではない。しかし、平均値の中に隠れていた選択肢を見えるようにし、私たちが何を選ぼうとしているのかを問い返してくれる。
編集注(2026-09-05)
旧稿ではAMMI/GGEバイプロットを多環境試験の主要な解析手法として紹介していた。今回の改稿では、AMMI/GGEをG×Eの理解・可視化の入口として位置づけ直し、FA混合モデル、不均衡MET、環境共変量を利用した反応規範型予測まで議論を拡張した。
実データとしてYan et al.(2000)で扱われたOntario冬コムギ試験を用い、AMMIおよびGGEバイプロットを再現した。図4の環境間相関は観測値に基づく単純相関であり、FA混合モデルによる推定遺伝相関とは区別する。
編集注(2026-09-13)
旧所属先のデータや分析結果は用いず、既存稿の公開研究・合成例に基づく説明を維持したうえで、2024〜2026年に公表された研究を追記した。予測対象による検証方法の違い、環境内の品種順位を評価する意味、因果解釈の限界、将来気象を扱う際の課題を補足している。今後の検証方針と展望は、著者が新たに実施した研究結果とは区別して記述した。
参考文献
- Fernandes, I. K., Vieira, C. C., Dias, K. O. G., & Fernandes, S. B. (2024). Using machine learning to combine genetic and environmental data for maize grain yield predictions across multi-environment trials. Theoretical and Applied Genetics, 137, 189.
- Avagyan, V., Boer, M. P., Solin, J., et al. (2025). Penalized factorial regression as a flexible and computationally attractive reaction norm model for prediction in the presence of GxE. Theoretical and Applied Genetics, 138, 88.
- Eckhoff, W., Parat, F., Bracho-Mujica, G., et al. (2026). Tailoring AI and ML models for genotype-by-environment prediction leveraging environmental covariates: A European rye example. Theoretical and Applied Genetics, 139, 206.
- Gauch, H. G. (1988). Model selection and validation for yield trials with interaction. Biometrics, 44(3), 705–715.
- Gauch, H. G., Piepho, H.-P., & Annicchiarico, P. (2008). Statistical analysis of yield trials by AMMI and GGE: Further considerations. Crop Science, 48(3), 866–889.
- Jarquín, D., Crossa, J., Lacaze, X., et al. (2014). A reaction norm model for genomic selection using high-dimensional genomic and environmental data. Theoretical and Applied Genetics, 127, 595–607.
- Kelly, A. M., Smith, A. B., Eccleston, J. A., & Cullis, B. R. (2007). The accuracy of varietal selection using factor analytic models for multi-environment plant breeding trials. Crop Science, 47(3), 1063–1070.
- Smith, A. B., Cullis, B. R., & Thompson, R. (2001). Analyzing variety by environment data using multiplicative mixed models and adjustments for spatial field trend. Biometrics, 57(4), 1138–1147.
- Yan, W., Hunt, L. A., Sheng, Q., & Szlavnics, Z. (2000). Cultivar evaluation and mega-environment investigation based on the GGE biplot. Crop Science, 40(3), 597–605.
- Zobel, R. W., Wright, M. J., & Gauch, H. G. Jr. (1988). Statistical analysis of a yield trial. Agronomy Journal, 80(3), 388–393.